SYSTEMS / CONFIGURATION / DEPLOYMENT
程式碼逐步發布,設定變更呢?
一個服務的程式碼更新,可能要經過測試、少量部署與健康檢查,再逐步擴大。
同一個服務的設定,卻可能只需要一次 API 呼叫,就在幾秒內影響整個環境。
如果只看程式碼的發布流程,我們可能會覺得保護已經很完整。我更想確認的是:還有哪些操作能改變正式環境的行為?它們受到什麼保護?
Cloudflare 的一次事故,讓這個問題變得很具體。
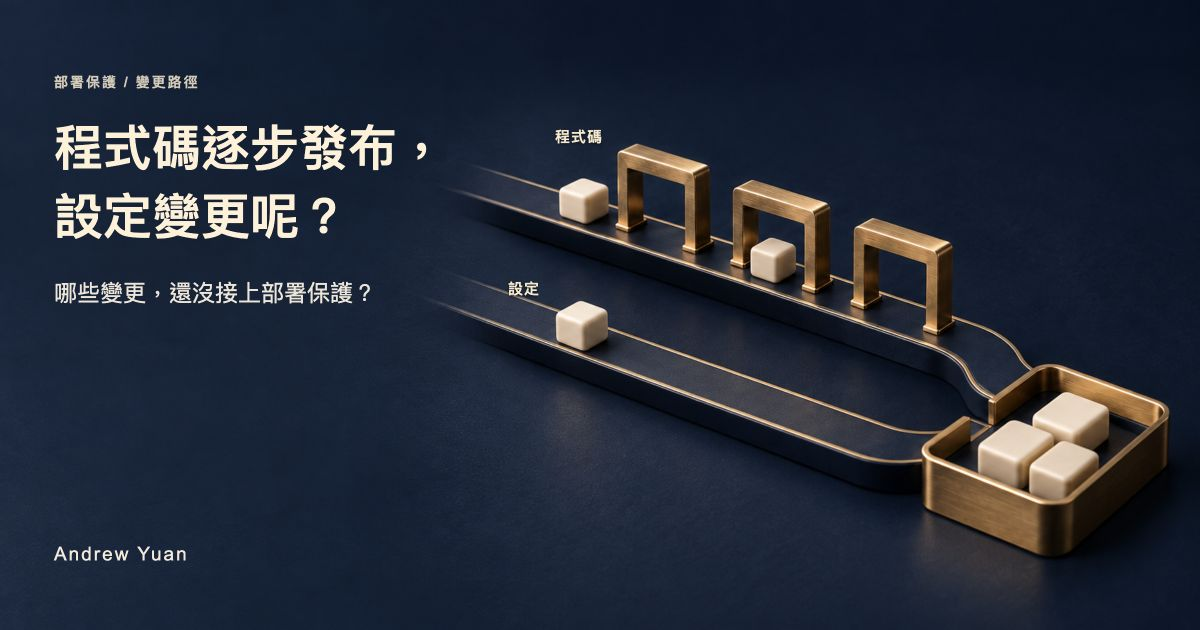
同一個服務,兩條不同的變更路徑
2025 年 12 月 5 日,Cloudflare 正逐步增加 WAF 的請求內容緩衝區大小。團隊發現內部測試工具不支援新的大小,便進行第二項變更,將它關閉。
第二項變更走的是幾秒內全域傳播的設定系統,觸發舊版 FL1 proxy 的 Lua 錯誤,讓符合受影響條件的請求收到 HTTP 500。報告指出,操作遵循既有程序,但此前未對 execute 類型的規則使用過該 kill switch。來源:Cloudflare 事故報告
因此,這個案例不能簡化成沒有遵守程序。既有做法曾經成功,仍需要確認它涵蓋了這次操作的條件。
操作的名稱也不足以判斷影響。「關閉測試工具」仍然改變了正式請求會走到的執行路徑。
我會沿著實際效果判斷風險:它改變什麼、先影響誰,又靠什麼限制影響範圍?
先看清楚,哪些入口可以改變服務
以下用一個假設的對外 HTTP API 服務來說明,並非上述公司的實際系統。
它有成熟的程式碼發布流程。團隊也能透過設定 API 修改流量限制,值班人員可以用 CLI 調整同一組設定,事故期間另有緊急開關。
這些介面並不一定形成缺口。CLI 可能呼叫和發布平台相同的受控後端;設定 API 也可能已具備版本管理、分批生效及回滾。要沿著實際路徑查,才能知道。
我會選一項流量限制變更,從提出要求一路追到應用程式採用:誰能操作?變更經過哪個後端?哪些請求先受到影響?什麼條件允許擴大?
Amazon Builders’ Library 描述了不同來源使用各自 pipeline、同時採用相似安全部署技術的做法,包含設定與功能旗標。這提供了一個有用的區分:路徑可以不同,保護的覆蓋範圍仍要逐一確認。來源:Amazon Builders’ Library
盤點完成後,「部署有保護」才有明確範圍,也才看得出哪些缺口需要投入。
分批推出之後,憑什麼繼續?
假設這個服務已經能先對少量執行個體套用設定,還需要確認這一小部分能提供什麼證據。
沒有相關流量,就難以觀察變更效果。若受測節點全部使用新版 runtime,也可能漏掉仍在使用舊版的其他節點。
只看全站平均錯誤率,則可能把小範圍內的嚴重退化稀釋掉。Google SRE 對 canary 的討論,特別重視受測群體、流量、觀察時間,以及指標能否歸因於變更。來源:Google SRE
回到流量限制的例子,我會希望看到受測與未受測群體的請求成功率、非預期拒絕和延遲,並確認觀察期間確實出現了會受到新限制影響的請求。設定能解析,是其中一項檢查。
團隊也要約定資料不足時如何處理。一般變更可能先暫停擴大;事故中的修復,則需要另外評估等待的代價。這是依服務情境作出的決定,不能讓「沒有數據」默默變成通過。
另外也要檢查隔離是否真的成立。若少量節點的變更仍會改寫共用資源,節點數少未必代表影響範圍小。
分批發布提供的是取得證據的機會。證據是否足夠,仍要看實際流量、相依關係與可觀察的結果。
平台提供能力,服務團隊完成接入
Cloudflare 在 2026 年 5 月發布的 Code Orange: Fail Small 後續報告中,介紹了 Snapstone,將漸進發布、健康監控與自動回滾整合到設定部署。報告也說明,過去實施這些保護,需要各團隊投入大量工作,因此接入並不一致。來源:Cloudflare 後續報告
如果每個團隊都要自行建立部署狀態、監控接線與回滾流程,這些工作就會持續和產品功能競爭。共用能力能減少重複建置,但遷移、接入與維護仍需要時間。
我的分工提案是:平台團隊維護共用的版本與部署控制;服務團隊定義有效的健康訊號,並確認各變更入口已接上適當保護;工程主管安排改善的資源與順序,讓有權承擔影響的人參與剩餘風險的決定。
驗收也需要跨過團隊邊界:一項受控變更,能否在預期故障下停止或復原?相關操作、告警與服務結果,有沒有留下可核對的紀錄?
否則平台可能認為工具已交付,服務團隊認為目前沒有遷移時間,而未受保護的路徑繼續存在。
接入之後也需要維護。新增一個操作介面、變更監控或調整服務架構時,都可能改變原本的保護範圍。
緊急變更,需要另一種準備
移除錯誤規則的開關若啟動得太慢,可能讓事故持續更久;快速操作也可能觸發另一個缺陷,擴大影響。
我會在事故之前,先區分已有明確受測用途的緊急操作,以及需要臨時判斷的新變更。兩者未必適合使用相同的速度與決策程序。
對假設服務的緊急開關,至少要先說清楚:可以加速哪些範圍、誰能決定、保留哪些觀測,以及結果不如預期時由誰停止或復原。
還有另一個問題:發生故障時,修復所需的存取與觀測路徑是否仍然可用?這和發布快慢不同,卻同樣影響救援。
Cloudflare 的後續報告指出,內部工具依賴自家基礎設施,事故可能影響修復所需的存取路徑,因此建立了備用授權路徑並進行演練。來源:Cloudflare 的緊急應變改善
應變能力需要平常的工程投入與演練。保留下來的緊急操作路徑,也需要持續維護。臨時開出的路徑若留下來,會成為下一次盤點不能漏掉的入口。
設定已發布,應用程式實際用了嗎?
設定發布端與使用端,未必同時完成。AWS AppConfig Agent 就採用本地快取與背景非同步輪詢,因此理解生效狀態,也需要看應用程式如何取得及使用設定。來源:AWS AppConfig Agent
對假設服務,我會分別記錄發布要求、設定版本、實際採用的版本與相關請求結果。部署工具已接受要求,還需要後面的證據才能判斷服務發生了什麼。
復原時也一樣:控制端回到舊設定後,還要確認服務端狀態。已經造成的外部效果,則可能需要另外處理。這也銜接到回退版本與目前資料是否相容的問題。
自動回滾還有自己的依賴。AWS AppConfig 文件明確指出,相關 CloudWatch 告警的動作被停用時,不會因此自動回滾。來源:自動回滾監控文件
所以我會把保護是否實際啟用,以及回滾後的服務結果,都納入驗收。這比只確認產品提供回滾功能,更接近我們對服務作出的承諾。
把缺口帶進下一次決策
假設這個 API 服務盤點後得到以下結果。這張表是示例,用來展示如何把發現轉成工作安排。
窄螢幕可左右滑動表格,查看完整內容。
| 變更入口 | 假設的盤點結果 | 接下來的決定 |
|---|---|---|
| 程式碼發布 | 已分批部署,健康結果可依版本區分 | 服務團隊維護指標與停止條件 |
| 設定 API | 有版本紀錄,但一次影響所有節點 | 優先補上限定範圍的發布能力;完成前限制可直接全域操作的變更 |
| 操作 CLI | 確認使用相同設定後端 | 設定保護完成時,連同 CLI 入口一起驗收 |
| 緊急開關 | 可快速生效,但受測用途有限 | 明列已測條件、決策人與復原步驟,安排演練 |
這時候,會議就能討論具體的取捨:設定 API 的影響是否值得優先投入?改善前要限制什麼?緊急開關缺少哪種演練?誰負責完成,團隊有沒有相應時間?
也不宜只用接入比例衡量完成度。一條能影響全體服務的未處理路徑,可能比許多低風險入口更值得先做。
我更在意的是,當有人說「這次只是改設定」,團隊能否接著回答:它會先影響誰?我們會看到什麼?憑什麼繼續?如果需要停下來,誰能做到?
這些答案足夠具體,才能支持發布速度、風險承擔與維護投入的決定。
來源與範圍
本文依據公開事故報告及技術文件分析;未實測文中的 Cloudflare 或 AWS 部署。假設服務、責任分工與驗收安排為作者提案。供應商自述的改善不等於獨立驗證或普遍的可靠性保證。